Partitionnement
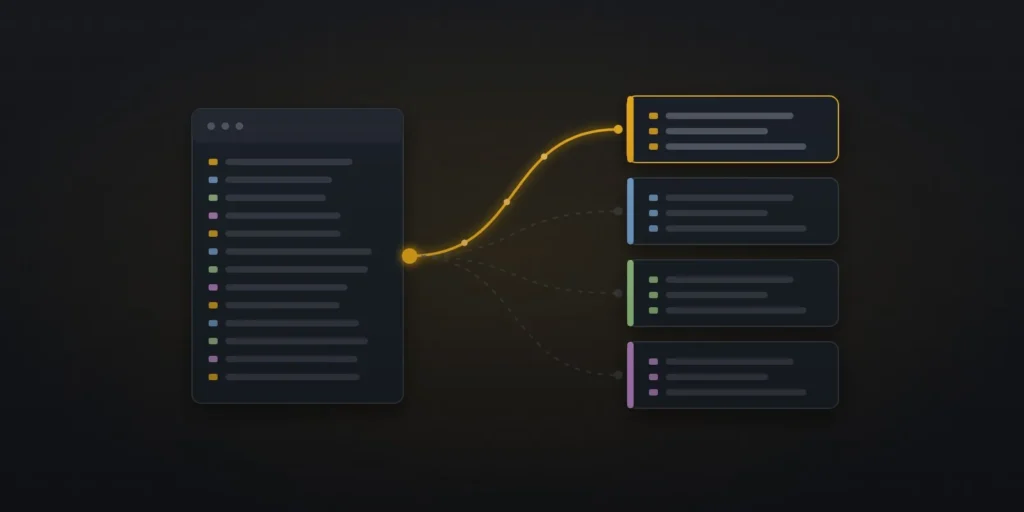
Découpage d’une grande table en sous-tables physiques, présentées comme une seule table logique.
Table partitionnée
Table parente sans données propres, qui route chaque ligne vers la bonne partition.
Clé de partition
Colonne (ou expression) qui détermine dans quelle partition une ligne est stockée.
RANGE
Partitionnement par plages de valeurs, typiquement par date (une partition par mois).
LIST
Partitionnement par liste de valeurs explicites, par exemple par pays ou par statut.
HASH
Partitionnement par hachage de la clé, pour répartir uniformément les lignes.
Partition DEFAULT
Partition qui reçoit les lignes ne correspondant à aucune autre partition.
Partition pruning
Optimisation du planificateur qui ignore les partitions inutiles pour une requête.
Index sur table partitionnée
Index déclaré sur la table parente et créé automatiquement sur chaque partition.
ATTACH / DETACH PARTITION
Commandes pour rattacher ou détacher une partition, utiles pour archiver ou charger des données sans bloquer la table.
Le partitionnement PostgreSQL découpe une très grande table en partitions plus petites, par plage, par liste ou par hachage. Dans l’univers du développement moderne, la gestion des données n’est plus une question de stockage brut, mais de vitesse d’accès et de maintenance. Nous faisons face à la « Loi de l’Accumulation des Données » : chaque année, le volume double, et la performance linéaire n’est plus suffisante.
Un développeur se concentre sur l’objet logique : une table transactions. Cependant, pour le moteur PostgreSQL, cette table est un fichier physique unique. Plus ce fichier grossit, plus les opérations fondamentales (scans, indexation, VACUUM) deviennent des goulots d’étranglement coûteux en I/O et en temps CPU.
Le problème de l’échelle : pourquoi les index ne suffisent plus
- Taille des Index : Un index massif demande plus de mémoire et de temps pour être maintenu et scanné.
- Verrouillage Global : Les opérations de maintenance (comme le nettoyage des lignes mortes) peuvent impacter l’ensemble de la table.
- I/O Disque : La lecture d’un bloc de données dans un fichier de 1 To prend plus de temps qu’un bloc dans un fichier de 1 Go.
La réponse architecturale est le Partitionnement Déclaratif de PostgreSQL. Il s’agit d’une refonte structurelle qui permet de diviser la table logique en plusieurs entités physiques autonomes, améliorant ainsi la concurrence et l’efficacité des requêtes.
Les trois stratégies de partitionnement
Le choix de la méthode de partitionnement est la décision la plus critique. Il doit refléter la manière dont l’application interroge et insère les données.
RANGE : partitionner par intervalle
Stratégie idéale pour les données naturellement ordonnées, notamment temporelles. Les partitions sont définies par des bornes inférieures et supérieures.
Clé : DATE, TIMESTAMP, ou NUMERIC.
LIST : partitionner par valeurs discrètes
Permet de segmenter les données sur un ensemble fini et connu de valeurs explicites.
Clé : Codes pays, statuts de commande, ID d’entrepôt.
HASH : répartir par hachage
Utilisé pour garantir une répartition uniforme des données lorsque la clé de partitionnement ne garantit pas une distribution équilibrée (ex: UUIDs). C’est une méthode de répartition forcée.
Clé : N’importe quelle colonne pour un nombre de partitions fixé.
Cas pratique : partitionner une table par date (RANGE)
Considérons une table de logs d’application. La très grande majorité des requêtes ne concerne que les 30 derniers jours.
CREATE TABLE app_logs (
    log_id BIGSERIAL,
    created_at TIMESTAMP NOT NULL,
    message TEXT
) PARTITION BY RANGE (created_at);

-- Partition du mois de mars 2025
CREATE TABLE logs_2025_03 PARTITION OF app_logs
FOR VALUES FROM ('2025-03-01') TO ('2025-04-01');

-- Partition du mois d'avril 2025
CREATE TABLE logs_2025_04 PARTITION OF app_logs
FOR VALUES FROM ('2025-04-01') TO ('2025-05-01');
L’avantage : Lorsque vous exécutez SELECT * FROM app_logs WHERE created_at BETWEEN '2025-03-15' AND '2025-03-17', l’optimiseur (via le Partition Pruning) ne lit que la partition logs_2025_03, ignorant complètement les milliards de lignes des autres mois. C’est l’essence même du gain de performance.
La partition par défaut (DEFAULT)
Une erreur courante est d’oublier que l’insertion d’une donnée qui ne correspond à aucune partition existante provoque une erreur fatale (ERROR: no partition found for row).
La solution : une partition DEFAULT
La partition DEFAULT agit comme un fourre-tout. Elle est essentielle pour intercepter les données avec des valeurs NULL sur la clé de partition, ou des valeurs inattendues. Elle doit être définie une seule fois.
CREATE TABLE sales_other PARTITION OF sales
DEFAULT;
Le piège à éviter
Si la partition DEFAULT devient trop grande, elle réintroduit le problème initial de performance. Elle doit rester petite et servir de zone de quarantaine pour les données à inspecter et à nettoyer. Il faut la surveiller de près !
Indexation et optimisation des requêtes
Le partition pruning : le secret de la vitesse
Le *Partition Pruning* est la raison n°1 d’utiliser le partitionnement. Lorsque vous utilisez la clause WHERE sur la clé de partition, l’optimiseur de requêtes exclut immédiatement les partitions qui ne peuvent pas contenir les données. Il ne les lit même pas.
Règle d’Or : Votre clause WHERE doit toujours (si possible) inclure la colonne de partitionnement pour activer l’élagage. Si vous cherchez des données sur une autre colonne sans spécifier la date (dans le cas d’un partitionnement par RANGE sur une date), l’optimiseur devra scanner toutes les partitions.
Index locaux par partition : la bonne pratique
PostgreSQL n’a pas d’index « globaux » qui couvrent toutes les partitions. Chaque partition est une table autonome, ce qui signifie que chaque partition doit avoir ses propres index. Cela permet d’isoler la maintenance et de réduire la taille effective de chaque index.
Exemple d’indexation locale
Chaque partition a un index sur la colonne user_id. Une recherche par ID n’est faite que dans la partition ciblée par la date.
CREATE INDEX idx_logs_2025_03_user ON logs_2025_03 (user_id);Cycle de vie des partitions : ATTACH et DETACH
Le véritable pouvoir du partitionnement réside dans la gestion dynamique du cycle de vie des données, c’est-à-dire l’archivage, la purge et l’ajout de nouvelles fenêtres temporelles sans indisponibilité de l’application.
Ajouter une partition sans interruption (ATTACH)
Créez la nouvelle partition (table) et ses index à l’avance, puis attachez-la en une seule opération de métadonnées, rapide et non bloquante.
-- 1. Créer la table
CREATE TABLE logs_2025_05 (
    log_id BIGSERIAL,
    created_at TIMESTAMP NOT NULL,
    message TEXT
);
-- 2. Attacher instantanément
ALTER TABLE app_logs
    ATTACH PARTITION logs_2025_05
    FOR VALUES FROM ('2025-05-01') TO ('2025-06-01');
Archiver ou supprimer une partition (DETACH)
Retirez une partition obsolète pour l’archiver ou la supprimer. Cela retire des milliards de lignes du système actif en quelques millisecondes.
-- 1. Détacher la partition
ALTER TABLE app_logs
    DETACH PARTITION logs_2024_11;
-- 2. Supprimer la table (DROP)
DROP TABLE logs_2024_11;
VACUUM, maintenance et concurrence
Le processus de VACUUM (nettoyage des lignes mortes) est grandement facilité. Au lieu d’avoir un processus long qui doit parcourir le fichier physique entier, chaque partition est « aspirée » indépendamment. Les opérations intensives de nettoyage et de gestion des verrous sont confinées à la partition active, garantissant une meilleure concurrence pour le reste de la table mère.
Conclusion : adopter une stratégie de données scalable
Le partitionnement n’est pas une solution miracle, mais une stratégie fondamentale pour tout développeur visant le statut de Senior Architecte. Il force à penser la gestion des données dans le temps et l’espace.
Dans une architecture microservices, chaque service possède sa propre base : le partitionnement s’applique alors service par service, là où le volume l’exige.
En utilisant le partitionnement, on ne se contente pas de diviser des tables ; on divise la charge I/O, on isole les problèmes de maintenance, et on s’assure que les requêtes critiques bénéficient toujours du Partition Pruning, garantissant ainsi que la performance reste stable, même face à une croissance exponentielle des données.
Maîtriser le partitionnement, c’est maîtriser l’évolution et la scalabilité de votre application.
Mettre PostgreSQL en pratique
Dans la formation Coder avec l’IA, vous concevez une base PostgreSQL sûre avec Supabase : migrations et contraintes, requêtes et index et Row Level Security.
Pour aller plus loin
- Formation Spring Boot : JPA, requêtes performantes et cache côté application.
- Design patterns : les 3 familles expliquées simplement.
- Spring Data JPA et Hibernate : entités, requêtes et pièges de performance côté application.